
写在前面:本博客仅作记录学习之用,部分图片来自网络,如需引用请注明出处,同时如有侵犯您的权益,请联系删除!
论文
论文名: BEVFusion: Multi-Task Multi-Sensor Fusion with Unified Bird‘s-Eye View Representation
论文速递: 点我转跳哦
代码通道: GitHub
背景
多传感器融合是实现精准、可靠自动驾驶系统的关键。现有方法多基于点级融合思路,即利用相机特征增强激光雷达(LiDAR)点云,但相机特征向激光雷达的投影过程会丢失语义密度,限制了这类方法的效果,在场景分割等面向语义的任务中表现尤为不佳。因此需要一种高效、通用的多任务多传感器融合框架,将多模态特征统一到共享的鸟瞰视角(BEV)表示空间中,能良好保留几何信息与语义信息。
如Waymo的自动驾驶车辆配备了29个相机、6个雷达和5个激光雷达。不同传感器提供互补的感知信息:相机捕捉丰富的语义信息,激光雷达提供高精度的空间几何信息,而雷达则能实现即时的速度估计。因此,多传感器融合是实现精准、可靠环境感知的核心环节。
不同传感器的采集数据具有本质不同的模态特征:相机以透视视角采集数据,激光雷达则为三维视角。为解决这种视角差异问题,需要找到一种统一的特征表示方式,适用于多任务、多模态的特征融合。
前人做法1:受二维感知任务巨大成功的启发,一种自然的思路是将激光雷达点云投影到相机平面,利用二维卷积神经网络(CNN)处理RGB-D数据。
前人做法1缺点:激光雷达到相机的投影会产生严重的几何畸变(见图1a),使其在三维目标识别等面向几何的任务中效果大打折扣。
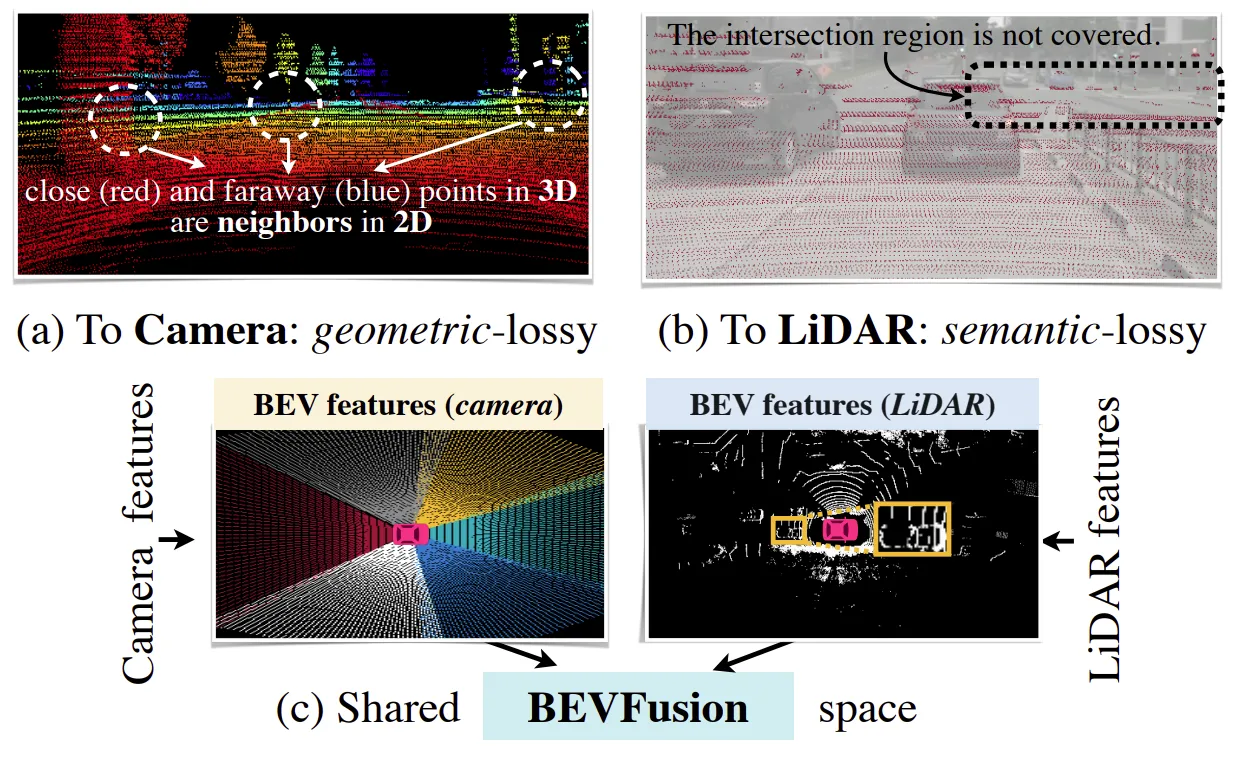
前人做法2:利用语义标签、卷积神经网络特征或二维图像生成的虚拟点对激光雷达点云进行增强,再基于改进的激光雷达检测算法预测三维边界框。
前人做法2缺点:相机特征向激光雷达的投影过程存在严重的语义损失(见图1b):对于典型的32线激光雷达,仅有5%的相机特征能与激光雷达点匹配,其余特征均会被丢弃。对于更稀疏的激光雷达(或雷达),密度差异会更加显著。故在大规模检测基准中表现出优异性能,但在鸟瞰视角地图分割等面向语义的任务中几乎难以奏效。
BEVFusion的做法:将多模态特征统一到共享的鸟瞰视角(BEV)表示空间,实现与任务无关的特征学习。该方法同时保留几何结构和语义密度(见图1c),并天然支持大多数三维感知任务(因其输出空间可自然映射到鸟瞰视角)。
效率瓶颈: 将特征转换为鸟瞰视角的过程中,仅BEV池化操作就占据了模型运行时间的80%以上。
为此,BEVFusion提出一种结合预计算和区间约简的专用核函数,实现40倍以上的加速。最后采用全卷积BEV编码器对统一的鸟瞰视角特征进行融合,并添加少量任务专用头,实现对不同目标任务的支持。
BEVFusion在nuScenes和Waymo两大基准数据集的三维目标检测任务中均达到当前最优性能,在有无测试时数据增强和模型集成的情况下,均优于所有已发表方法。
环境感知分类
- 基于激光雷达的三维感知:部分工作利用PointNet或稀疏卷积网络(SparseConvNet)提取激光雷达点云的扁平化特征,并在鸟瞰视角空间完成检测。后续研究进一步探索了无锚框的单阶段三维目标检测方法。另一类研究聚焦于双阶段检测器设计,在单阶段检测器基础上增加RCNN网络,提升检测性能。
- 基于相机的三维感知:FCOS3D在图像检测器基础上扩展了三维回归分支。与在透视视角执行目标检测不同,部分方法基于DETR设计检测头,在三维空间中引入可学习的目标查询机制。受激光雷达基检测器设计思路的启发,另一类纯相机三维感知模型通过视角变换器,将相机特征从透视视角显式转换为鸟瞰视角。BEVDet和M2BEV将LSS和OFT方法扩展到三维目标检测任务,CaDDN则为视角变换器添加了显式的深度估计监督。近期研究也探索了结合多头注意力机制的视角变换方法。
- 多传感器融合:现有方法可分为提议级融合和点级融合两类。早期方法MV3D在三维空间生成目标提议框,并将其投影到图像平面提取感兴趣区域(RoI)特征。部分研究则将图像提议框映射到三维视锥空间。近期工作FUTR3D和TransFusion在三维空间定义目标查询,并将图像特征融合到这些提议框上。所有提议级融合方法均以目标为中心,无法直接扩展到鸟瞰视角地图分割等其他任务。另一方面,点级融合方法通常将相机语义特征映射到前景激光雷达点上,在增强后的点云输入上执行基于激光雷达的检测。因此,这类方法同时以目标和几何为中心。其中,部分研究属于(激光雷达)输入级增强,而DCF和DeepFusion则为特征级增强。
与所有现有方法不同,BEVFusion在共享的鸟瞰视角空间执行传感器融合,对前景与背景、几何与语义信息同等对待,是一种通用的多任务多传感器感知框架。
方法
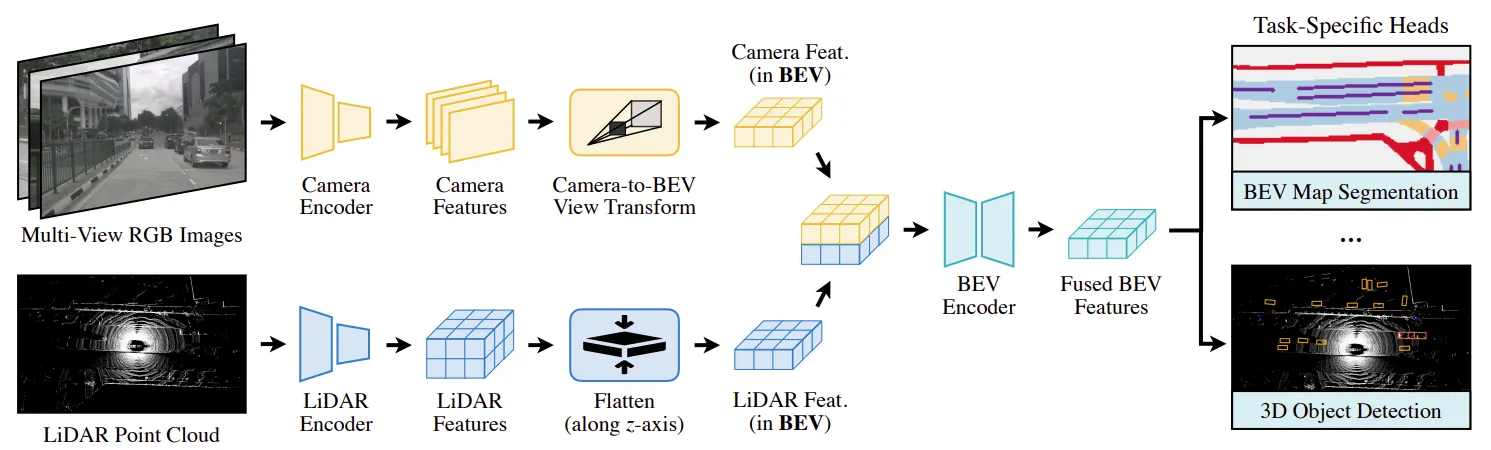
如图2所示,BEVFusion聚焦于多视角相机与激光雷达的多传感器融合,实现三维检测和分割等多任务感知。针对不同的传感器输入,首先通过模态专用编码器提取特征,将多模态特征转换为统一的鸟瞰视角表示,同时保留几何信息和语义信息;随后分析视角变换的效率瓶颈,通过预计算和区间约简加速BEV池化操作;接着采用基于卷积的BEV编码器,缓解不同特征间的局部错位问题;最后添加少量任务专用头,实现对不同三维任务的支持。
统一特征表示
不同传感器的特征具有不同的视角属性:相机特征为透视视角,激光雷达/雷达特征通常为三维/鸟瞰视角;视角差异导致特征融合难度大
合理的表示方法要求:
- (1)所有传感器特征均可轻松转换为该表示,且无信息损失;
- (2)该表示适用于不同类型的感知任务。
投影至相机视角:受RGB-D数据启发,一种选择是将激光雷达点云投影到相机平面,生成二维半稀疏深度图。
缺点:存在严重的几何损失,深度图中的相邻点在三维空间中可能相距甚远,使得相机视角在三维目标检测等关注目标/场景几何的任务中效果不佳。
投影至激光雷达视角:大多数当前最优的传感器融合方法通过相机特征(语义标签、卷积特征或虚拟点)对激光雷达点进行增强。
缺点:相机到激光雷达的投影存在严重的语义损失:相机与激光雷达特征的密度差异极大,对于32线激光雷达,仅有不到5%的相机特征能与激光雷达点匹配。舍弃相机特征的语义密度,会严重降低模型在鸟瞰视角地图分割等面向语义的任务中的性能。在隐空间的融合方法(如目标查询)也存在类似缺陷。
投影至鸟瞰视角:鸟瞰视角(BEV)作为融合的统一特征表示。
优点:对几乎所有感知任务均具有良好的适配性,因其输出空间本身也为鸟瞰视角;转换到鸟瞰视角的过程能同时保留激光雷达特征的几何结构和相机特征的语义密度。一方面,激光雷达到鸟瞰视角的投影沿高度维度扁平化稀疏的激光雷达特征,不会产生图1a中的几何畸变;另一方面,相机到鸟瞰视角的投影将每个相机特征像素映射回三维空间的一条射线(下一节详细说明),能生成图1c中的稠密鸟瞰视角特征图,完整保留相机的语义信息。
高效的相机到鸟瞰视角变换
相机到鸟瞰视角的变换具有一定挑战性,因为每个相机特征像素对应的深度具有固有模糊性。BEVFusion沿用LSS方法,显式预测每个像素的离散深度分布,随后将每个特征像素沿相机射线分散到D个离散点,并根据对应的深度概率对特征进行缩放(图3a),生成尺寸为$NHWD$的相机特征点云(N为相机数量,$(H,W)$为相机特征图尺寸)。将该三维特征点云沿$y$轴以步长$r$(如0.4米)量化,通过BEV池化操作聚合每个$r×r$鸟瞰视角网格内的所有特征,并沿$z$轴扁平化特征。
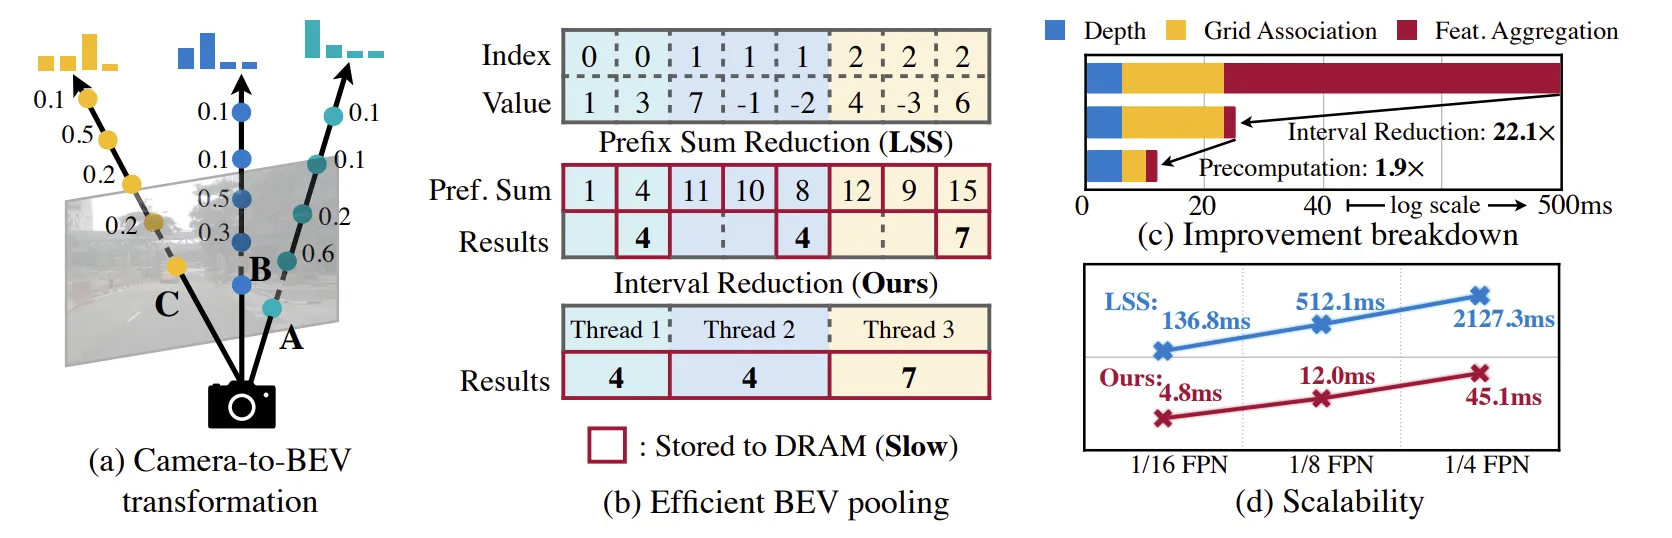
BEV池化操作的效率极低、速度极慢:在RTX 3090 GPU上,该操作的耗时超过500毫秒,而模型其余部分的总耗时仅约100毫秒。
原因在于相机特征点云的规模极大:对于典型的计算任务,每帧会生成约200万个点,密度是激光雷达特征点云的两个数量级。
为突破这一效率瓶颈,BEVFusion提出结合预计算和区间约简的方法优化BEV池化操作。
注:典型配置为N=6个多视角相机,每个相机的特征图尺寸为$(H,W)=(32,88)$(由256×704的原始图像下采样8倍得到),深度在[1,60]米范围内按0.5米步长离散为$D=(60-1)/0.5=118$个区间。*
预计算
BEV池化的第一步是将相机特征点云中的每个点与鸟瞰视角网格关联。与激光雷达点云不同,相机特征点云的坐标是固定的(相机内参和外参完成标定后通常保持不变)。基于这一特性,预计算每个点的三维坐标和鸟瞰视角网格索引,并根据网格索引对所有点进行排序,记录每个点的排序序号。在推理阶段,仅需根据预计算的序号对特征点重新排序即可,能将网格关联的延迟从17毫秒降低至4毫秒。
区间约简
网格关联后,同一鸟瞰视角网格内的所有点在张量表示中连续排列。BEV池化的下一步是通过均值、最大值、求和等对称函数,聚合每个网格内的特征。
现有方法缺点:现有实现首先对所有点计算前缀和,再在网格索引变化的边界处进行差值计算,如图3b所示。然而,前缀和操作需要在GPU上执行树约简,且会生成大量未使用的部分和(仅需边界处的数值),导致效率极低。
为加速特征聚合,本文设计了一种专用的GPU核函数,直接对鸟瞰视角网格进行并行计算:为每个网格分配一个GPU线程,由线程计算该网格的区间和并将结果写回。该核函数消除了输出之间的依赖关系(无需多级树约简),且避免了将部分和写入动态随机存取存储器(DRAM),将特征聚合的延迟从500毫秒降低至2毫秒(图3c)。
关键结论
通过优化的BEV池化操作,相机到鸟瞰视角的变换速度提升40倍以上:延迟从500毫秒以上降至12毫秒,仅占模型端到端运行时间的10%,且在不同特征分辨率下具有良好的可扩展性(图3d)。这是实现多模态传感器特征在共享鸟瞰视角表示中统一的关键支撑。我们的两项同期工作也发现了纯相机三维检测中的这一效率瓶颈,分别通过假设均匀深度分布[41]或截断每个BEV网格内的点[40]来近似视角变换器;与之不同,本文方法无需任何近似,实现精确变换的同时保持更高的速度。
全卷积特征融合
将所有传感器特征转换为共享的鸟瞰视角表示后,可通过拼接等按元素操作轻松实现特征融合。尽管处于同一空间,但由于视角变换器的深度估计存在误差,激光雷达和相机的鸟瞰视角特征仍可能存在一定的空间错位。为此,采用基于卷积的BEV编码器(包含少量残差块),补偿这种局部错位问题。
多任务头
在融合后的鸟瞰视角特征图上添加多个任务专用头,该方法可适用于大多数三维感知任务。
- 对于三维目标检测,本文采用类专用中心热力图头预测所有目标的中心位置,并通过多个回归头估计目标的尺寸、旋转角度和速度。
- 对于地图分割,不同的地图类别可能存在重叠(如人行横道属于可行驶区域的子集),因此将该问题建模为多二值语义分割任务,为每个类别单独设计分割分支,并沿用CVT的方法,采用标准焦点损失训练分割头。
实验
本文在三维目标检测和鸟瞰视角地图分割任务中,评估BEVFusion在相机-激光雷达融合中的性能,涵盖面向几何和面向语义的两类典型任务。该框架可轻松扩展到雷达、事件相机等其他传感器,以及三维目标跟踪、运动预测等其他三维感知任务。
实验设置
模型:采用Swin-T作为图像骨干网络,VoxelNet作为激光雷达骨干网络;通过特征金字塔网络(FPN)融合多尺度相机特征,生成1/8输入尺寸的特征图;将相机图像下采样至256×704,激光雷达点云在检测任务中以0.075米为体素尺寸、分割任务中以0.1米为体素尺寸进行体素化。由于检测和分割任务需要不同空间范围和尺寸的鸟瞰视角特征图,在每个任务专用头前通过双线性插值的网格采样,显式实现不同鸟瞰视角特征图之间的转换。
数据集:在nuScenes和Waymo两大大规模三维感知数据集上进行评估,两个数据集均包含超过4万个标注场景,且每个样本均配备激光雷达和多视角相机输入。
三维目标检测
首先在面向几何的三维目标检测基准上进行实验,结果表明BEVFusion在更低的计算成本和延迟下实现了更优的性能。采用10类前景目标的平均精度(mAP)和nuScenes检测得分(NDS)作为检测指标;在RTX 3090 GPU上,测量所有开源方法的单次推理乘加运算量(MACs)和延迟;验证集和测试集的结果均由单一模型得到,未使用任何测试时数据增强。
如表1所示,BEVFusion在nuScenes检测基准上达到当前最优性能,在桌面级GPU上实现近实时的推理速度(8.4帧/秒)。与TransFusion相比,BEVFusion在测试集上的mAP和NDS提升1.3%,同时乘加运算量降低1.9倍,实测延迟降低1.3倍;与代表性的点级融合方法PointPainting和MVP相比,实现1.6倍的速度提升、1.5倍的乘加运算量降低,且测试集mAP提升3.8%。
BEVFusion的效率提升源于将鸟瞰视角空间作为共享融合空间,该方式能充分利用所有相机特征,而非仅利用5%的稀疏特征子集。因此,BEVFusion可在相机输入分辨率大幅降低的情况下实现相同性能,从而显著减少乘加运算量;结合高效的BEV池化算子,BEVFusion成功将乘加运算量的降低转化为实际的速度提升。
表1 BEVFusion在nuScenes数据集(验证集/测试集)的三维目标检测性能
BEVFusion在无额外优化的情况下达到当前最优性能,打破了将相机特征映射到激光雷达点云的传统思路,在计算成本降低1.5-2倍的同时,mAP和NDS至少提升1.3%。(*:本文重新实现;†:使用测试时数据增强)
| 方法 | 模态 | 测试集mAP | 测试集NDS | 验证集mAP | 验证集NDS | 乘加运算量(G) | 延迟(ms) |
|---|---|---|---|---|---|---|---|
| M2BEV | 相机 | 42.9 | 47.4 | 41.7 | 47.0 | – | – |
| BEVFormer | 相机 | 44.5 | 53.5 | 41.6 | 51.7 | – | – |
| PointPillars | 激光雷达 | – | – | 52.3 | 61.3 | 65.5 | 34.4 |
| SECOND | 激光雷达 | 52.8 | 63.3 | 52.6 | 63.0 | 85.0 | 69.8 |
| CenterPoint | 激光雷达 | 60.3 | 67.3 | 59.6 | 66.8 | 153.5 | 80.7 |
| PointPainting | 相机+激光雷达 | – | – | 65.8* | 69.6* | 370.0 | 185.8 |
| PointAugmenting | 相机+激光雷达 | 66.8† | 71.0† | – | – | 408.5 | 234.4 |
| MVP | 相机+激光雷达 | 66.4 | 70.5 | 66.1* | 70.0* | 371.7 | 187.1 |
| FusionPainting | 相机+激光雷达 | 68.1 | 71.6 | 66.5 | 70.7 | – | – |
| AutoAlign | 相机+激光雷达 | – | – | 66.6 | 71.1 | – | – |
| FUTR3D | 相机+激光雷达 | – | – | 64.5 | 68.3 | 1069.0 | 321.4 |
| TransFusion | 相机+激光雷达 | 68.9 | 71.6 | 67.5 | 71.3 | 485.8 | 156.6 |
| BEVFusion | 相机+激光雷达 | 70.2 | 72.9 | 68.5 | 71.4 | 253.2 | 119.2 |
BEVFusion在Waymo开放数据集上也达到当前最优性能(表2),仅使用60%的输入帧,性能即优于此前最优的多模态检测器DeepFusion;此外,DeepFusion结合了25个模型并使用测试时数据增强,而BEVFusion仅对单一BEVFusion模型使用测试时数据增强,即实现更优的性能。
表2 BEVFusion在Waymo开放数据集(测试集)的三维目标检测性能
(†:使用测试时数据增强;‡:同时使用测试时数据增强和模型集成)
| 方法 | 帧数 | mAP/L1 | mAPH/L1 | mAP/L2 | mAPH/L2 |
|---|---|---|---|---|---|
| AFDetV2-Ens‡ | 3 | 84.1 | 82.6 | 79.0 | 77.6 |
| InceptionLiDAR | 10 | 83.8 | 82.5 | 79.2 | 77.8 |
| 3DAL-Ens | 5 | 84.6 | 83.1 | 79.7 | 78.2 |
| DeepFusion-Ens‡ | 5 | 84.4 | 83.2 | 79.5 | 78.4 |
| MT-Net‡ | 3 | 84.7 | 83.2 | 79.9 | 78.5 |
| MT3D | 4 | 85.0 | 83.7 | 80.1 | 78.7 |
| LIVOX-Detection | 7 | 84.8 | 83.5 | 80.2 | 79.0 |
| MPPNet-Ens‡ | 16 | 85.0 | 83.7 | 80.5 | 79.1 |
| 3DAM-Ens | 5 | 85.3 | 83.8 | 80.7 | 79.2 |
| BEVFusion† | 3 | 85.7 | 84.4 | 80.8 | 79.5 |
鸟瞰视角地图分割
面向语义的鸟瞰视角地图分割任务中,将BEVFusion与当前最优模型进行对比,结果表明该方法在该任务中实现了更为显著的性能提升。采用6类背景目标的交并比(IoU)和类别平均交并比(mIoU)作为评估指标;由于不同类别可能存在重叠(如停车场属于可行驶区域),我们对每个类别单独评估二值分割性能,并在不同阈值下选择最高交并比;遵循的设置,仅在自车周围[-50米,50米]×[-50米,50米]的区域内对每帧进行评估。
表3为鸟瞰视角地图分割的实验结果。与作为几何导向任务的三维目标检测不同,地图分割是语义导向任务。因此,纯相机的BEVFusion模型在性能上优于纯激光雷达基线模型8-13%,这一结果与表1完全相反(表1中当前最优的纯相机三维检测器比纯激光雷达检测器的mAP低近20%)。我们的纯相机模型将现有单目鸟瞰视角地图分割方法的性能提升至少12%;在多模态设置下,单目BEVFusion的交并比进一步提升6%,且比当前最优的传感器融合方法提升13%以上。
PointPainting仅对前景激光雷达点进行增强,MVP仅对前景三维目标进行增密,两种方法均对地图组件的分割无帮助;更糟糕的是,两种方法均假设激光雷达是传感器融合中更有效的模态,而表3的结果表明这一假设并不成立。
表3 BEVFusion在nuScenes数据集(验证集)的鸟瞰视角地图分割性能
BEVFusion在鸟瞰视角地图分割任务中,比当前最优的多传感器融合方法提升13.6%,且在所有类别上均实现稳定提升。
| 方法 | 模态 | 可行驶区域 | 人行横道 | 人行道 | 停止线 | 停车场 | 道路分隔带 | 均值 |
|---|---|---|---|---|---|---|---|---|
| OFT | 相机 | 74.0 | 35.3 | 45.9 | 27.5 | 35.9 | 33.9 | 42.1 |
| LSS | 相机 | 75.4 | 38.8 | 46.3 | 30.3 | 39.1 | 36.5 | 44.4 |
| CVT | 相机 | 74.3 | 36.8 | 39.9 | 25.8 | 35.0 | 29.4 | 40.2 |
| M2BEV | 相机 | 77.2 | – | – | – | – | 40.5 | – |
| BEVFusion | 相机 | 81.7 | 54.8 | 58.4 | 47.4 | 50.7 | 46.4 | 56.6 |
| PointPillars | 激光雷达 | 72.0 | 43.1 | 53.1 | 29.7 | 27.7 | 37.5 | 43.8 |
| CenterPoint | 激光雷达 | 75.6 | 48.4 | 57.5 | 36.5 | 31.7 | 41.9 | 48.6 |
| PointPainting | 相机+激光雷达 | 75.9 | 48.5 | 57.1 | 36.9 | 34.5 | 41.9 | 49.1 |
| MVP | 相机+激光雷达 | 76.1 | 48.7 | 57.0 | 36.9 | 33.0 | 42.2 | 49.0 |
| BEVFusion | 相机+激光雷达 | 85.5 | 60.5 | 67.6 | 52.0 | 57.0 | 53.7 | 62.7 |
分析
光照与天气条件
表4分析了BEVFusion在不同光照和天气条件下的性能。由于传感器噪声,纯激光雷达模型在雨天的目标检测性能大幅下降,而BEVFusion利用相机传感器的鲁棒性,mAP提升10.7%,大幅缩小了晴天和雨天的性能差距。光照条件不佳对检测和分割模型均构成挑战:在检测任务中,MVP的性能提升远低于BEVFusion,原因在于BEVFusion对精准的二维实例分割生成虚拟点的依赖更低,因此在黑暗或过曝场景中表现更优;在分割任务中,纯相机的BEVFusion在整个基准上的性能优于CenterPoint,但在夜间的性能大幅下降;而多模态BEVFusion的mIoU提升12.8%,甚至超过白天的提升幅度,这表明当相机传感器失效时,利用几何线索的重要性。
表4 BEVFusion在不同光照和天气条件下的鲁棒性
BEVFusion具有优异的鲁棒性,在雨天(+10.7%)和夜间(+12.8%)等具有挑战性的场景中,性能显著优于单模态模型。
| 方法 | 模态 | 晴天 | 雨天 | 白天 | 夜间 | ||||
|---|---|---|---|---|---|---|---|---|---|
| mAP | mIoU | mAP | mIoU | mAP | mIoU | mAP | mIoU | ||
| CenterPoint | 激光雷达 | 62.9 | 50.7 | 59.2 | 42.3 | 62.8 | 48.9 | 35.4 | 37.0 |
| BEVFormer | 相机 | 41.0 | – | 44.0 | – | 41.9 | – | 21.2 | – |
| BEVFusion | 相机 | – | 59.0 | – | 50.5 | – | 57.4 | – | 30.8 |
| MVP | 相机+激光雷达 | 65.9) | 51.0 | 66.3 | 42.9 | 66.3 | 49.2 | 38.4 | 37.5 |
| BEVFusion | 相机+激光雷达 | 68.2 | 65.6 | 69.9 | 55.9 | 68.5 | 63.1 | 42.8 | 43.6 |
目标尺寸与距离
从图4a可以看出,BEVFusion对小型和大型目标的性能均持续优于纯激光雷达模型,而MVP对尺寸大于4米的目标几乎无性能提升。原因在于大型目标的点云通常更稠密,从多模态虚拟点增强中的获益更少。此外,BEVFusion对小型目标(图4a)和远距离目标(图4b)的性能提升更为显著,这两类目标均难以被激光雷达充分捕捉,因此能从稠密的相机信息中获得更多收益。
激光雷达稀疏性
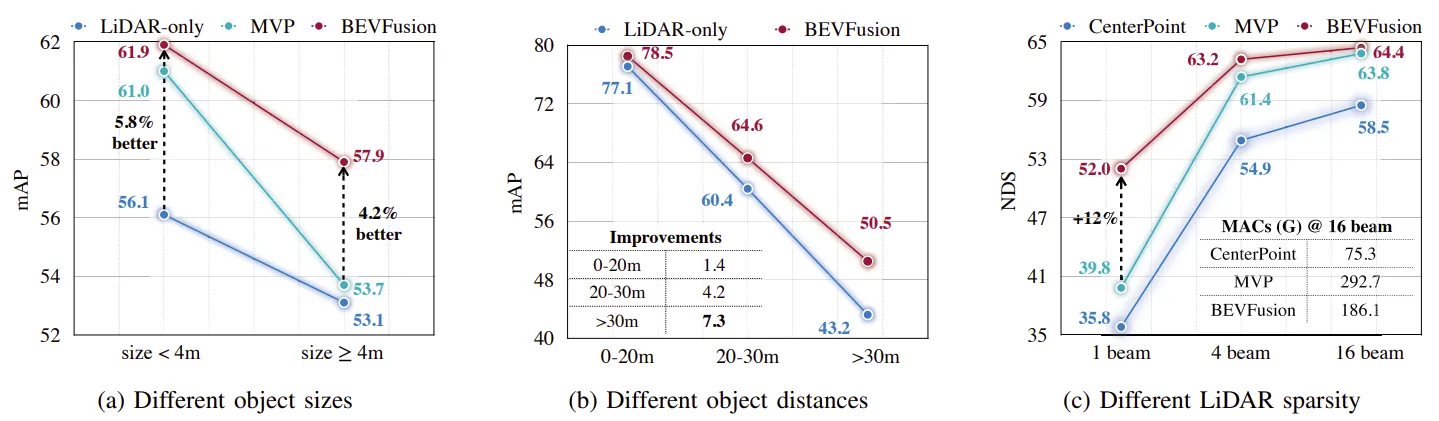
本文验证了CenterPoint(纯激光雷达)、MVP(多模态)和BEVFusion在不同激光雷达稀疏性下的性能(图4c)。BEVFusion在所有稀疏性水平下均持续优于MVP,且乘加运算量降低1.6倍,在1线激光雷达场景中性能提升12%。MVP对激光雷达点云进行增强后,直接在增强后的点云上执行CenterPoint检测,因此该方法的性能依赖于纯激光雷达检测器(CenterPoint)的性能,而这在激光雷达稀疏的场景中并不理想(图4c中1线激光雷达的NDS仅为35.8)。与之相反,BEVFusion在共享的鸟瞰视角空间整合多传感器信息,无需依赖鲁棒的纯激光雷达检测器。
总结
总结: 本文提出BEVFusion,一种高效、通用的多任务多传感器三维感知框架。该框架将相机和激光雷达特征统一到共享的鸟瞰视角空间,充分保留几何信息和语义信息;通过将相机到鸟瞰视角的变换速度提升40倍以上,突破了多模态融合的效率瓶颈。BEVFusion重新思考了点级融合在多传感器感知系统中的有效性,在nuScenes数据集的三维检测和鸟瞰视角地图分割任务中,均实现了更优的性能,同时计算成本降低1.5-1.9倍,速度提升1.3-1.6倍;在Waymo开放数据集上,该方法也优于所有现有传感器融合方法。我们希望BEVFusion能成为简洁且强大的研究基准,为未来多任务多传感器融合的研究提供启发。
致谢
欲尽善本文,因所视短浅,怎奈所书皆是瞽言蒭议。行文至此,诚向予助与余者致以谢意。
参考
[1]BEVFusion: Multi-Task Multi-Sensor Fusion with Unified Bird‘s-Eye View Representation